Ein Kunde benötigt ein Ersatzteil für seine Verpackungsmaschine. Statt selbst den Produktkatalog des Herstellers zu durchsuchen, beauftragt er einen persönlichen KI-Agenten, das passende Teil zu identifizieren, seine Verfügbarkeit zu prüfen und eine Bestellung vorzubereiten. Der Agent kennt das Maschinenmodell und die technischen Anforderungen. Auf der Herstellerwebsite findet er Produktbeschreibungen, Ersatzteilkataloge und einen Konfigurator. Ob er damit seine Aufgabe tatsächlich erledigen kann, hängt jedoch davon ab, wie das Unternehmen diese Informationen und Funktionen bereitstellt.
Für menschliche Besucher erschließen Navigation, Suchfunktionen und Benutzeroberflächen die Handlungsmöglichkeiten eines digitalen Angebots. Ein externer Kundenagent benötigt darüber hinaus maschinenlesbare Informationen, nachvollziehbare Beschreibungen verfügbarer Funktionen und einen geeigneten technischen Zugriff auf diese Funktionen. Soll er im Auftrag einer Person handeln, kommen Anforderungen an Identität, Berechtigungen und die Kontrolle seiner Aktionen hinzu.
Mit dieser Entwicklung haben wir uns bereits in unseren Beiträgen zum zweiten Traffic-Typ und zur Agentic Experience in der Praxis beschäftigt. Dort stand die Frage im Vordergrund, wie externe Customer Proxy Agents auf digitale Touchpoints zugreifen und welche Veränderungen sich daraus für die Experience-Architektur ergeben.
Im nächsten Schritt müssen wir die Perspektive wechseln: Was müssen Unternehmen bereitstellen, damit externe Kundenagenten ihre Angebote nicht nur finden und verstehen, sondern im Auftrag ihrer Nutzerinnen und Nutzer tatsächlich nutzen können?
Vier Fähigkeiten für die Bereitstellung digitaler Angebote an Kundenagenten
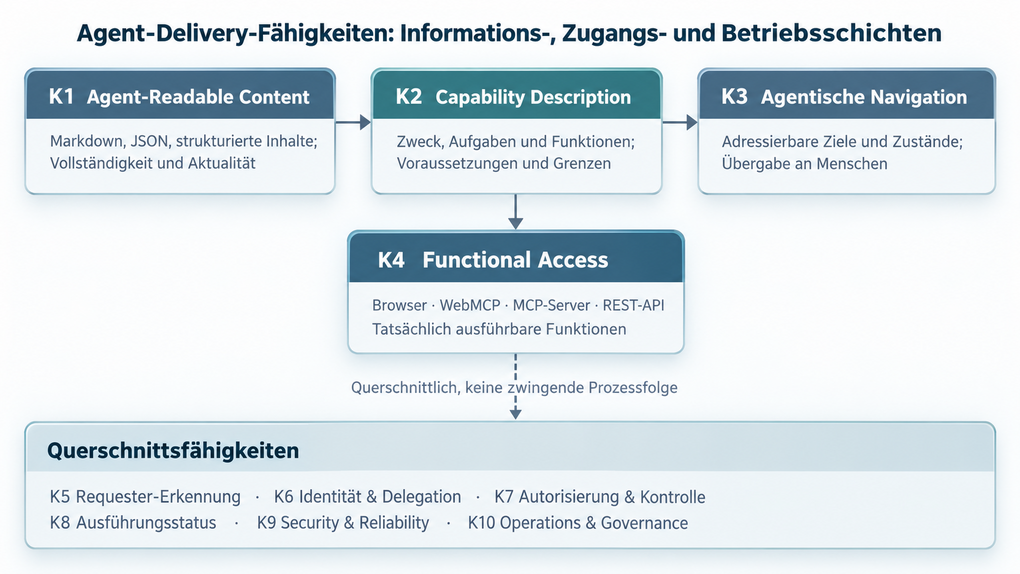
Für diese Betrachtung unterscheiden wir vier Agent-Delivery-Fähigkeiten. Sie beschreiben unterschiedliche Anforderungen an die digitale Bereitstellung und bilden ein Arbeitsmodell für die Bewertung bestehender Unternehmensangebote. Die vier Bereiche sind dabei keine technischen Implementierungsstufen. Sie können unabhängig voneinander entwickelt werden, müssen für komplexere Kundenaufgaben aber zusammenspielen.
- Agent-Readable Content (Informationen verwertbar bereitstellen): Produktdaten, Serviceinformationen, Bedingungen und Dokumentationen müssen für externe Agenten zugänglich und interpretierbar sein. Dazu gehören strukturierte Daten, konsistente Produktattribute und geeignete Ausgabeformate.
- Capability Description (Handlungsmöglichkeiten beschreiben): Agenten müssen erkennen können, welche Leistungen ein Unternehmen anbietet, welche Aufgaben sich darüber erledigen lassen und welche Voraussetzungen oder Einschränkungen gelten.
- Agentische Navigation (Informations- und Interaktionsziele erreichbar machen): Agenten benötigen Möglichkeiten, bestimmte Inhalte, Funktionen und gegebenenfalls Interaktionszustände gezielt anzusteuern. Dazu gehört auch die Frage, wie ein Vorgang bei Bedarf an einen Menschen übergeben werden kann.
- Functional Access (Geschäftsfunktionen tatsächlich nutzbar machen): Externe Agenten müssen angebotene Funktionen technisch ausführen können. Das kann über vorhandene Weboberflächen, dokumentierte APIs oder spezielle Agentenprotokolle erfolgen.
Am Beispiel der Ersatzteilbestellung wird die Unterscheidung greifbar. Ein Agent kann die technischen Produktdaten auswerten, ohne zu wissen, ob der Hersteller eine Kompatibilitätsprüfung anbietet. Er kann diese Funktion entdecken, ohne einen geeigneten Zugriff darauf zu erhalten. Und selbst wenn er die Prüfung erfolgreich ausführt, ist damit noch nicht geklärt, ob er eine verbindliche Bestellung vornehmen darf.
Die vier Fähigkeiten hängen also fachlich zusammen, adressieren aber unterschiedliche Probleme. Deshalb lohnt die getrennte Betrachtung. Eine gut strukturierte Website ist nicht zwangsläufig für agentische Interaktionen geeignet. Umgekehrt garantiert eine funktionierende API noch nicht, dass ein externer Kundenagent das verfügbare Angebot entdecken, verstehen und zuverlässig nutzen kann.
Warum maschinenlesbare Inhalte allein nicht ausreichen
Für den ersten Bereich entstehen bereits konkrete technische Angebote. Cloudflare ermöglicht beispielsweise mit Markdown for Agents, HTML-Seiten über Content Negotiation auch als Markdown auszuliefern. Ein Client kann die entsprechende Ausgabe über den HTTP-Accept-Header anfordern. Die Funktion setzt voraus, dass der Dienst für die betreffende Website aktiviert wurde. Die genannten Angebote dienen als Beispiele und sind keine Produktempfehlung.
Eine solche Konvertierung kann die Verarbeitung vorhandener Inhalte erleichtern. Sie ergänzt allerdings keine fehlenden Informationen. Wenn ein Ersatzteilkatalog keine maschinenlesbaren Kompatibilitätsangaben enthält, werden diese durch die Umwandlung in Markdown auch nicht verfügbar.
Ähnlich differenziert ist die Diskussion um llms.txt zu betrachten. Der Vorschlag sieht eine kuratierte Übersicht relevanter Inhalte für Sprachmodelle vor. Google hat 2026 im Leitfaden zur Optimierung für generative KI-Funktionen klargestellt, dass für die Google Suche keine zusätzlichen maschinenlesbaren Dateien oder KI-Textdateien nötig sind. Andere Systeme können sie dennoch verwenden. Eine verlässliche universelle Erkennung lässt sich daraus nicht ableiten.
Schon auf der Content-Ebene gilt: Unternehmen müssen prüfen, welche Informationen ein Agent für eine konkrete Kundenaufgabe benötigt und ob diese Informationen tatsächlich vollständig, verständlich und aktuell zugänglich sind. Die Wahl eines maschinenfreundlichen Formats ist nur ein Teil dieser Aufgabe.
Welche Integrationskonzepte und Standards für Agent Delivery entstehen
Während die Bereitstellung von Inhalten auf vorhandenen Webtechnologien aufbauen kann, entwickeln sich für die Beschreibung und Ausführung von Funktionen zunehmend agentenspezifische Integrationsansätze. Dabei gibt es nicht den einen technischen Standard, der alle Anforderungen abdeckt.
Die verfügbaren Konzepte unterscheiden sich danach, ob ein Agent eine bestehende Oberfläche bedient, eine Unternehmensfunktion direkt aufruft, mit einem anderen Agenten kommuniziert oder einen definierten Geschäftsprozess ausführt. Für die Einordnung ist deshalb wichtiger, welche Aufgabe ein Protokoll übernimmt, als die Frage, welcher Ansatz sich insgesamt durchsetzen wird.
| Konzept | Integrationsprinzip | Einordnung |
|---|---|---|
| Browserbasierter Zugriff | Bedienung vorhandener Webseiten und Formulare | Nutzt bestehende Human Interfaces |
| REST APIs / OpenAPI | Dokumentierter Direktzugriff auf Daten und Funktionen | Etablierte Integrationsgrundlage |
| WebMCP | Webseiten bieten ihre Funktionen als aufrufbare Tools an | Agentenfunktionen im Webinterface |
| MCP | Standardisierte Anbindung von Tools und Datenquellen | Allgemeiner Funktions- und Datenzugriff |
| A2A | Kommunikation und Aufgabenbearbeitung zwischen Agenten | Agentenübergreifende Zusammenarbeit |
| UCP | Beschreibung und Ausführung standardisierter Commerce-Fähigkeiten | Agentische Handelsprozesse |
| ACP | Produktintegration und Checkout für agentische Einkaufsszenarien | Agentischer Commerce und Transaktionen |
Von der Browserbedienung zum strukturierten Funktionszugriff
Der technisch unmittelbar verfügbare Weg ist die browserbasierte Bedienung vorhandener Weboberflächen. Agenten können Seiten aufrufen, Formulare ausfüllen und mehrstufige Interaktionen durchführen, soweit die jeweilige Oberfläche und die eingesetzte Agententechnologie dies zulassen. Unternehmen müssen dafür keine besonderen Agentenschnittstellen anbieten. Allerdings bleiben solche Zugriffe von der Stabilität und Bedienbarkeit ihrer Oberflächen abhängig.
Einen gezielteren Zugriff ermöglichen dokumentierte REST-APIs. Mit OpenAPI existiert dafür ein etablierter Standard zur Beschreibung von HTTP-Schnittstellen. Für externe Kundenagenten reicht das Vorhandensein einer API allein allerdings nicht aus. Sie müssen die Schnittstelle entdecken können, ihre Funktionen verstehen und mit passenden Berechtigungen nutzen dürfen.
Hier setzen neuere Integrationskonzepte an. Das Model Context Protocol (MCP) standardisiert die Verbindung von KI-Anwendungen mit externen Tools und Datenquellen. Unternehmen können entsprechende Funktionen über MCP-Server bereitstellen. In unserem früheren Beitrag „Model Context Protocol: Neuer Standard oder Repackaging bewährter Konzepte?“ haben wir die Entwicklung bereits eingeordnet.
WebMCP verfolgt einen verwandten Gedanken innerhalb der Webanwendung. Über eine JavaScript-Schnittstelle können Webseiten Funktionen mit Beschreibungen und strukturierten Eingabeschemas als Tools anbieten. Das Konzept berücksichtigt ausdrücklich die Zusammenarbeit von Menschen und Agenten innerhalb derselben Weboberfläche. Die Spezifikation liegt seit dem 16. Oktober 2026 als Draft Community Group Report vor und ist noch kein verabschiedeter W3C-Standard.
Es gibt also zwei Möglichkeiten, Funktionen für Agenten zugänglich zu machen: über eine serverseitig bereitgestellte Schnittstelle oder über die Funktionalität einer geöffneten Webanwendung. Beide Wege können sinnvoll sein, abhängig davon, ob ein Agent unabhängig vom Browser arbeiten oder eine bestehende Interaktion mit einer Person unterstützen soll.
Von der Funktionsbeschreibung zur Zusammenarbeit zwischen Agenten
Mit dem Agent2Agent Protocol (A2A) kommt eine weitere Integrationslogik hinzu. A2A ist darauf ausgerichtet, die Kommunikation und Zusammenarbeit zwischen Agenten zu ermöglichen. Über sogenannte Agent Cards können Agenten ihre Identität, Fähigkeiten, unterstützten Kommunikationswege und weitere Eigenschaften maschinenlesbar beschreiben.
Für Agent Delivery wird dieser Ansatz interessant, wenn ein externer Kundenagent nicht unmittelbar einzelne Unternehmensfunktionen aufruft, sondern Aufgaben an einen unternehmenseigenen Agenten übergibt. Dieser könnte beispielsweise eine Ersatzteilberatung durchführen, benötigte Informationen abfragen und die Ergebnisse an den anfragenden Agenten zurückgeben.
A2A und MCP adressieren dabei unterschiedliche Integrationsaufgaben. MCP stellt vor allem Tools und Daten für KI-Anwendungen zugänglich bereit. A2A beschreibt die Zusammenarbeit zwischen eigenständigen Agenten. Daraus ergibt sich keine zwingende Entscheidung für einen der beiden Ansätze. Vielmehr können beide in einer Agentenarchitektur unterschiedliche Rollen übernehmen.
UCP und ACP: Wenn Agenten Geschäftsprozesse ausführen
Besonders konkret werden die Integrationsanforderungen im E-Commerce. Mit dem Universal Commerce Protocol (UCP) und dem Agentic Commerce Protocol (ACP) liegen zwei Ansätze vor, die agentische Einkaufsszenarien unterstützen.
UCP sieht unter anderem maschinenlesbare Unternehmensprofile vor. Händler können darüber veröffentlichen, welche Commerce-Dienste und Funktionen sie unterstützen, welche Schnittstellen verfügbar sind und welche Spezifikationsversionen gelten. Laut UCP-Spezifikation veröffentlichen Unternehmen dieses Profil unter /.well-known/ucp. Die Dokumentation zeigt damit eine konkrete Verbindung zwischen Capability Description und Functional Access.
ACP beschreibt eine Integration, bei der Händler strukturierte Produktinformationen bereitstellen und Checkout-Prozesse über definierte Schnittstellen ermöglichen. Händler setzen dafür laut OpenAI die Agentic-Checkout-Spezifikation um. Die Dokumentation behandelt außerdem Produkt-Feeds und delegierte Zahlungen.
Beide Ansätze zeigen, wie aus der Bereitstellung von Produktinformationen ein ausführbarer Geschäftsprozess werden kann. Sie unterscheiden sich in Architektur und Integrationsmodell und sind derzeit vor allem im Kontext spezifischer Commerce-Anwendungen relevant. Daraus lässt sich noch kein allgemeiner Standard für sämtliche agentischen Kundeninteraktionen ableiten.
Für die Weiterentwicklung der Digital Experience ist dennoch eine wesentliche Veränderung erkennbar: Digitale Angebote können zunehmend über definierte Leistungen und Funktionen zugänglich gemacht werden, ohne dass die gesamte Kundeninteraktion über das eigene Frontend stattfinden muss.
Agentenzugriff braucht Identität, Berechtigungen und nachvollziehbare Ausführung
Mit der technischen Nutzbarkeit von Unternehmensfunktionen ist die Agent Delivery noch nicht vollständig beschrieben. Sobald externe Agenten Informationen mit Kundenbezug abrufen oder verbindliche Aktionen ausführen sollen, müssen Unternehmen zusätzliche Anforderungen berücksichtigen. Dazu gehören die Identifizierung des anfragenden Systems, der Nachweis einer zulässigen Beauftragung und die Kontrolle der tatsächlich ausgeführten Handlungen.
Drei Fragen sind dabei zu unterscheiden: Wer stellt die Anfrage? In wessen Auftrag wird gehandelt? Und welche konkrete Handlung darf ausgeführt werden?
Für die erste Frage entsteht mit Web Bot Auth ein entsprechender technischer Ansatz. Der IETF-Entwurf vom 1. September 2026 beschreibt, wie automatisierte Clients HTTP-Anfragen kryptografisch signieren und Server diese Signaturen überprüfen können. Der Entwurf befindet sich weiterhin in der Standardisierung. Eine überprüfbare Agentenidentität belegt jedoch noch keinen gültigen Kundenauftrag.
Für die Autorisierung von Funktionen liefert die MCP-Spezifikation unter anderem OAuth-basierte Mechanismen, definierte Zugriffsrechte und die Möglichkeit, zusätzliche Berechtigungen anzufordern. Die Implementierung einer Autorisierung ist allerdings nicht für jeden MCP-Einsatz verpflichtend. Unternehmen müssen deshalb selbst festlegen, welche ihrer Funktionen geschützt werden und welche Berechtigungsprüfungen erforderlich sind.
Noch spezifischer adressiert das Agent Payments Protocol (AP2) die Autorisierung agentischer Zahlungen. Das Konzept verwendet kryptografisch überprüfbare Mandate, mit denen sich die Freigabe einer Bestellung und die Berechtigung zur Zahlung nachweisen lassen. Es unterscheidet dabei auch zwischen vorab begrenzten Handlungsaufträgen und der Autorisierung einer konkreten Transaktion.
Vertrauenswürdige Agent Delivery geht über klassische Schnittstellensicherheit hinaus. Ein Unternehmen muss nachvollziehen können, ob ein Agent im Rahmen eines zulässigen Auftrags handelt, welche Grenzen für seine Aktionen gelten und welches Ergebnis tatsächlich erzielt wurde.
Customer Trust wird zur Voraussetzung für delegierte Kundeninteraktionen
Für das Customer Experience Management bekommt diese Unterscheidung eine zusätzliche Bedeutung. Kundenagenten handeln zwar technisch eigenständig, ihre Aktionen müssen aber weiterhin den Interessen und Entscheidungen der beauftragenden Personen entsprechen. Unternehmen benötigen deshalb Mechanismen, mit denen sich kritische Entscheidungen bestätigen, Transaktionen nachvollziehen und fehlerhafte Vorgänge kontrollieren lassen.
Auch die Verantwortung für die Leistung verschwindet nicht, wenn ein Agent die Interaktion übernimmt. Das gilt auch für agentische Checkouts: Die Nutzung eines Agenten verändert den Interaktionsweg, ersetzt aber nicht die Verantwortung des Händlers für Bestellung und Leistung.
Für Unternehmen entsteht daraus eine Gestaltungsaufgabe, die technische Architektur, Customer Experience und Governance verbindet. Sie müssen ihre Leistungen für externe Agenten nutzbar machen und gleichzeitig sicherstellen, dass Berechtigungen, Entscheidungen und Ergebnisse für die beteiligten Menschen nachvollziehbar bleiben.
Wie gut sind Unternehmen bereits auf Agent Delivery vorbereitet?
Die beschriebenen Standards und Integrationskonzepte eröffnen unterschiedliche Wege, digitale Angebote für externe Kundenagenten zugänglich zu machen. Welche davon sinnvoll sind, hängt von den vorhandenen Systemen und den konkreten Kundenaufgaben ab. Nicht jedes Unternehmen benötigt unmittelbar einen MCP-Server, einen eigenen Unternehmensagenten oder die Integration in ein Commerce-Protokoll.
Für die Bewertung des bestehenden Bereitstellungsstands lassen sich jedoch einige grundlegende Fragen formulieren:
- Informationen: Können externe Agenten die erforderlichen Produkt-, Service- und Prozessinformationen vollständig und zuverlässig verarbeiten?
- Fähigkeiten: Ist eindeutig beschrieben, welche Kundenaufgaben über das digitale Angebot erledigt werden können?
- Navigation: Lassen sich die erforderlichen Informationsstellen, Funktionen und Interaktionszustände gezielt erreichen?
- Funktionszugriff: Welche Aktionen kann ein externer Agent tatsächlich ausführen, und wie zuverlässig funktionieren diese Zugriffe?
- Berechtigungen: Wie werden Identität, Kundenauftrag, Zugriffsrechte und Freigaben überprüft?
- Betrieb und Kontrolle: Können Unternehmen ausgeführte Aktionen, Transaktionszustände und Fehler nachvollziehen und bei Bedarf eingreifen?
Diese Fragen bilden den Ausgangspunkt unserer Assessments von Shift/CX. Sie sollen helfen, die technischen Bereitstellungsfähigkeiten für externe Kundenagenten systematisch zu betrachten und bestehende Lücken zu identifizieren. Im Mittelpunkt steht dabei zunächst die Fähigkeit, externe Agentenzugriffe kontrolliert zu ermöglichen, nicht die vollständige Neugestaltung aller digitalen Kundenprozesse.
Die Entwicklung ist für das Digital Experience Management auch deshalb relevant, weil sich die Nutzung digitaler Angebote zunehmend von deren sichtbarer Oberfläche lösen kann. Ein Produktvergleich, eine Serviceanfrage oder eine Bestellung muss nicht mehr vollständig innerhalb der Website des anbietenden Unternehmens stattfinden. Die Leistung selbst bleibt jedoch an die Informationen, Funktionen und Prozesse des Unternehmens gebunden.
Damit erweitert sich die Aufgabe des Digital Experience Managements: Neben der Gestaltung menschlicher Interaktionen müssen Unternehmen künftig auch die Bereitstellung ihrer Leistungen für externe, im Kundenauftrag handelnde Systeme berücksichtigen.
Wir legen großen Wert auf sachliche und unabhängige Beiträge. Um nachvollziehbar zu machen, unter welchen Rahmenbedingungen unsere Inhalte entstehen, geben wir folgende Hinweise:
- Partnerschaften: Vorgestellte Lösungsanbieter können Partner oder Sponsoren unserer Veranstaltungen sein. Dies beeinflusst jedoch nicht die redaktionelle Auswahl oder Bewertung im Beitrag.
- Einsatz von KI-Tools: Bei der Texterstellung und grafischen Aufbereitung unterstützen uns KI-gestützte Werkzeuge. Die inhaltlichen Aussagen beruhen auf eigener Recherche, werden redaktionell geprüft und spiegeln die fachliche Einschätzung des Autors wider.
- Quellenangaben: Externe Studien, Daten und Zitate werden transparent kenntlich gemacht und mit entsprechenden Quellen belegt.
- Aktualität: Alle Inhalte beziehen sich auf den Stand zum Zeitpunkt der Veröffentlichung. Spätere Entwicklungen können einzelne Aussagen überholen.
- Gastbeiträge und Interviews: Beiträge von externen Autorinnen und Autoren – etwa in Form von Interviews oder Gastbeiträgen – sind klar gekennzeichnet und geben die jeweilige persönliche Meinung wieder.